無料AI画像ジェネレーター - 製品・ソーシャルビジュアル作成
プロンプトを実際の製品シーン、ソーシャル広告、ブログカバー、サムネイル、キャンペーンドラフトに変えるなら、無料AI画像ジェネレーターをご利用ください。テキストから始めて結果を確認し、最適な画像を編集、image-to-image、アップスケーリングへ。登録不要、透かしなし。
世界中の12,000,000人以上のユーザーに信頼されています。
テキストからAI画像を生成する方法
最初のパスは画面上で判断できる程度に直接的に。最適なプロンプトは被写体、背景、カメラ距離、照明、最終用途を指定。
プロンプトを書く
1つの主要被写体、その周囲のシーン、ビジュアルスタイル、画像の使用場所を説明。
生成して比較
何が機能したか確認する前にアイデアを追加せず、最新結果をプロンプトと照合。
ダウンロードまたは調整
良い結果を保存、または方向性が近いが最終的でない場合はエディター、image-to-image、アップスケーラーに送信。
AI画像ジェネレーターで何が作成できる?
ジェネレーターは4つの実用的な作業に:ソーシャル・広告コンセプト、製品シーンモックアップ、エディトリアルカバー、初回画像生成後の次ステップワークフロー。
ソーシャル・広告コンセプト
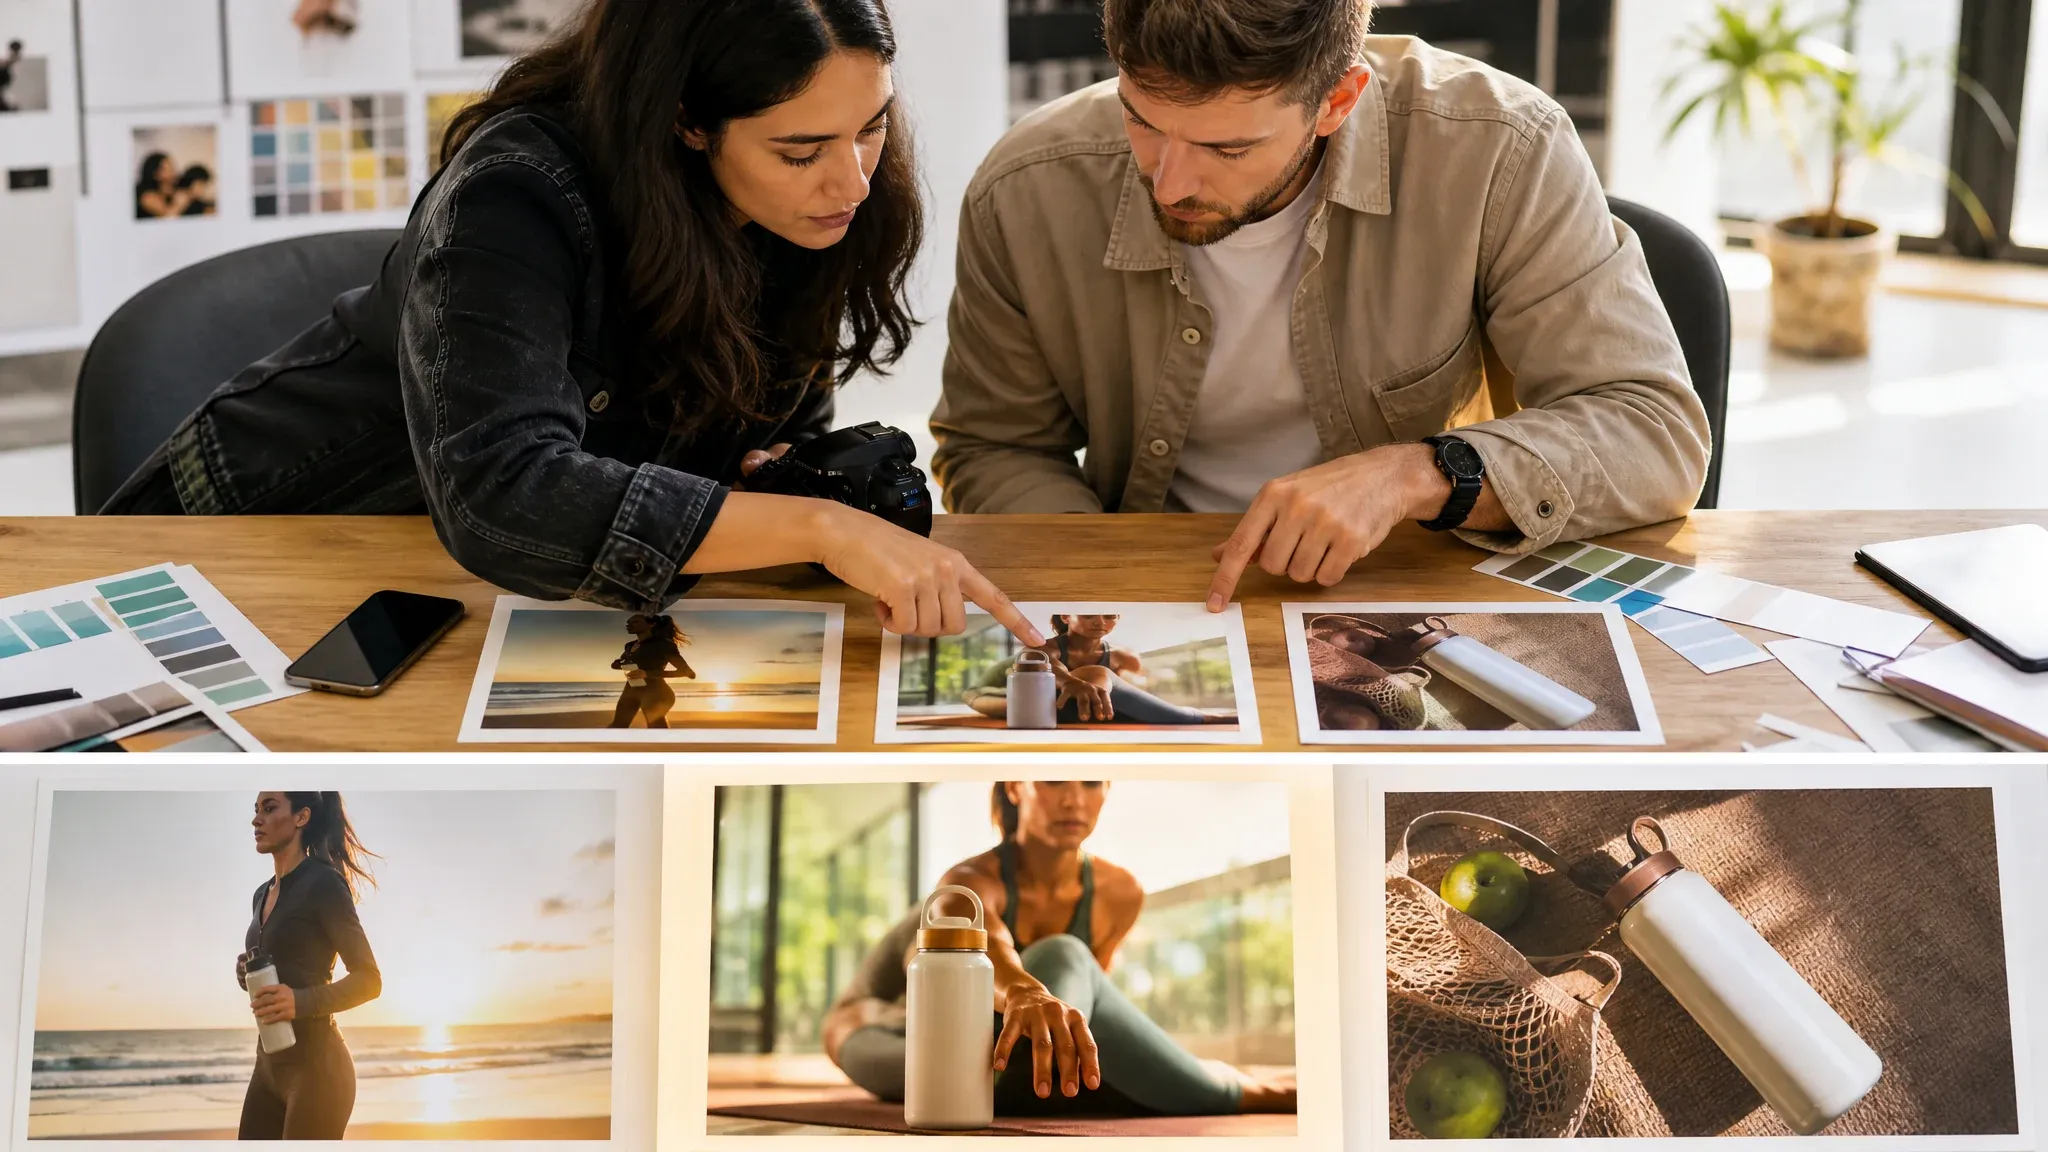
キャンペーンフックを有料ソーシャル、サムネイル、ローンチ投稿、クリエイティブレビュー向けのビジュアルオプションに変換。製品、オーディエンス、背景、フレーム形状を指定するプロンプトを使用。
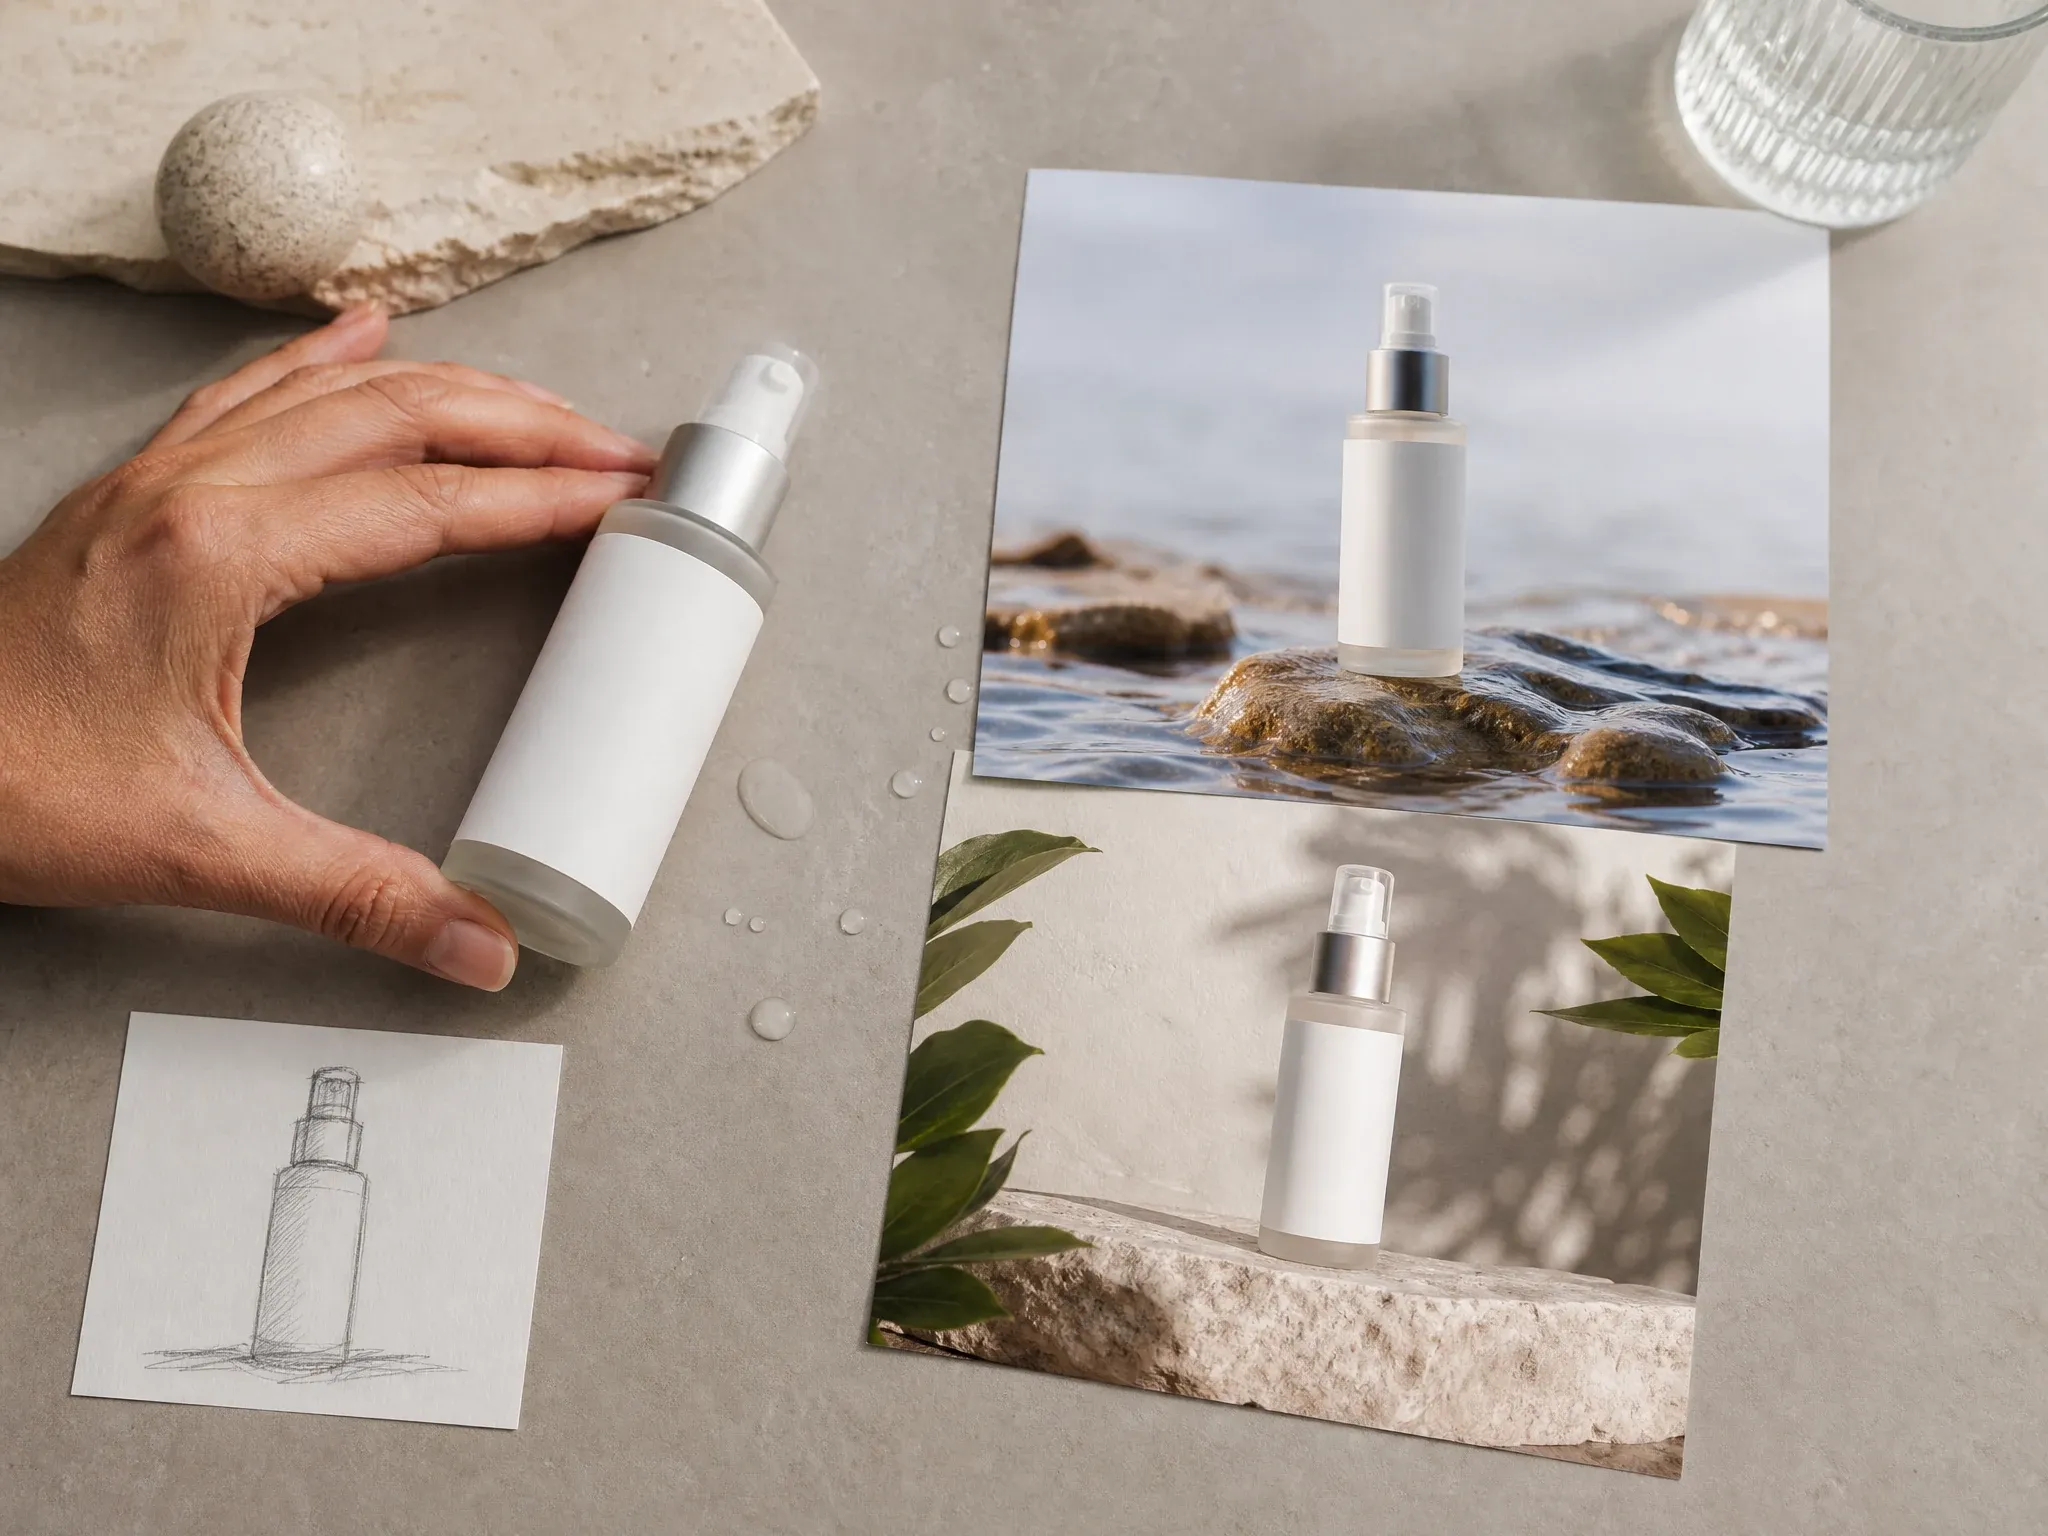
製品シーンモックアップ
撮影前に製品コンセプト画像を作成。ブランク包装、表面素材、照明、カメラ距離が、曖昧なブランド形容詞よりも重要。
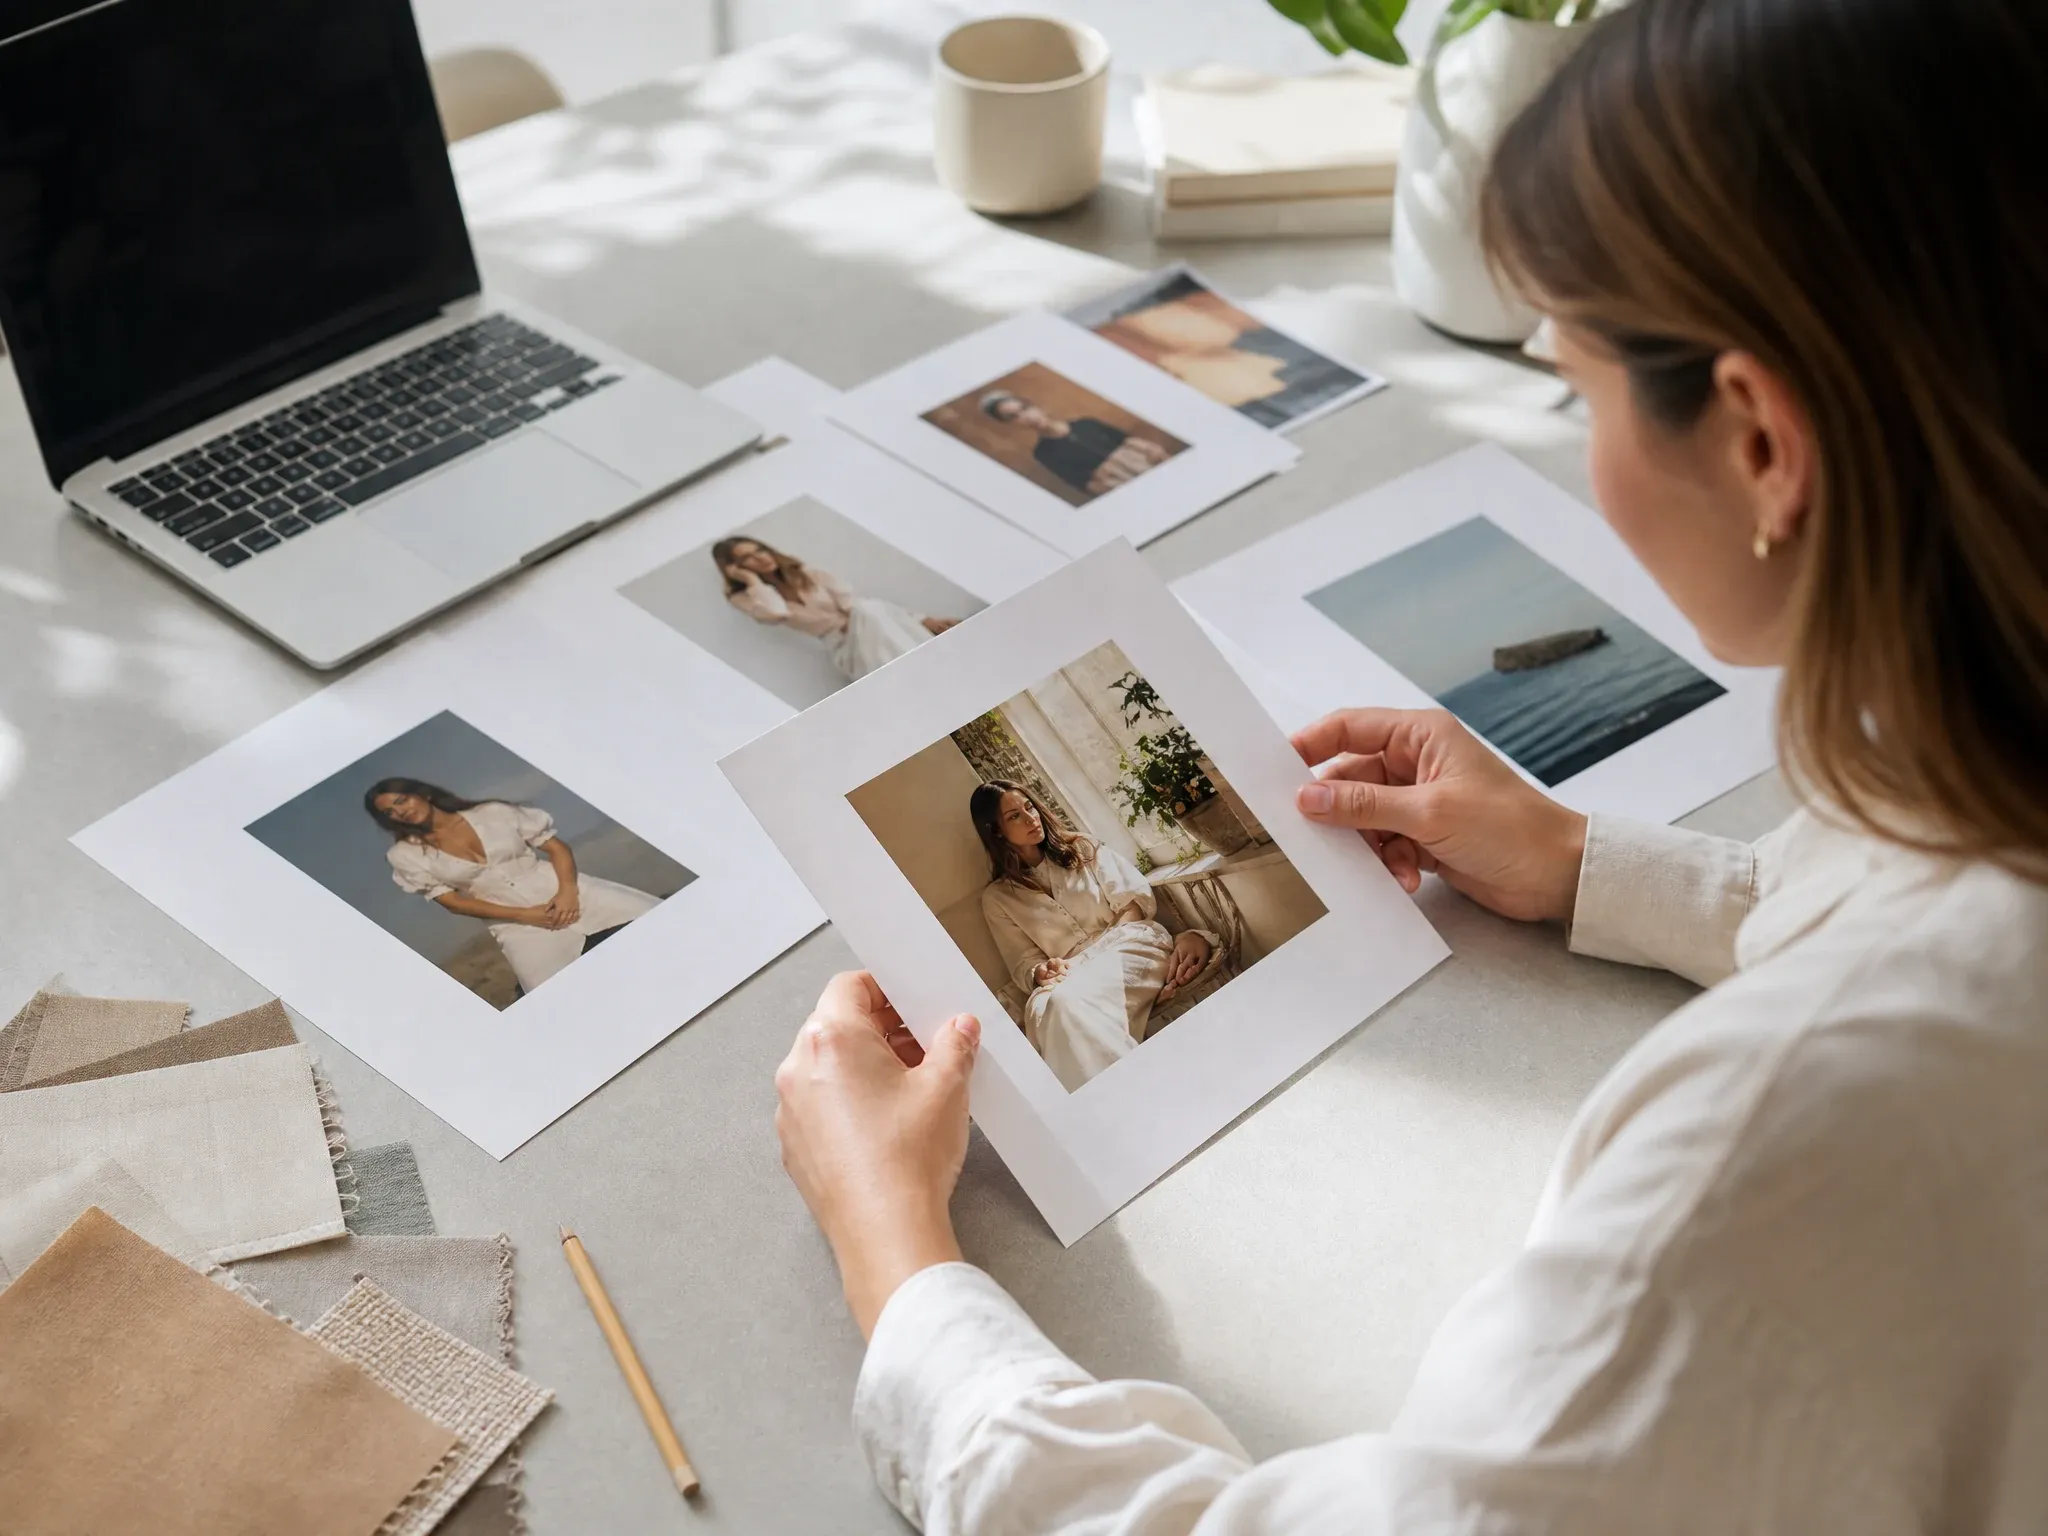
エディトリアル・ブログカバー
ストック画像が合わない場合の記事アート作成。読者、設定、雰囲気から始め、ストーリーを支えるフレームを選択。
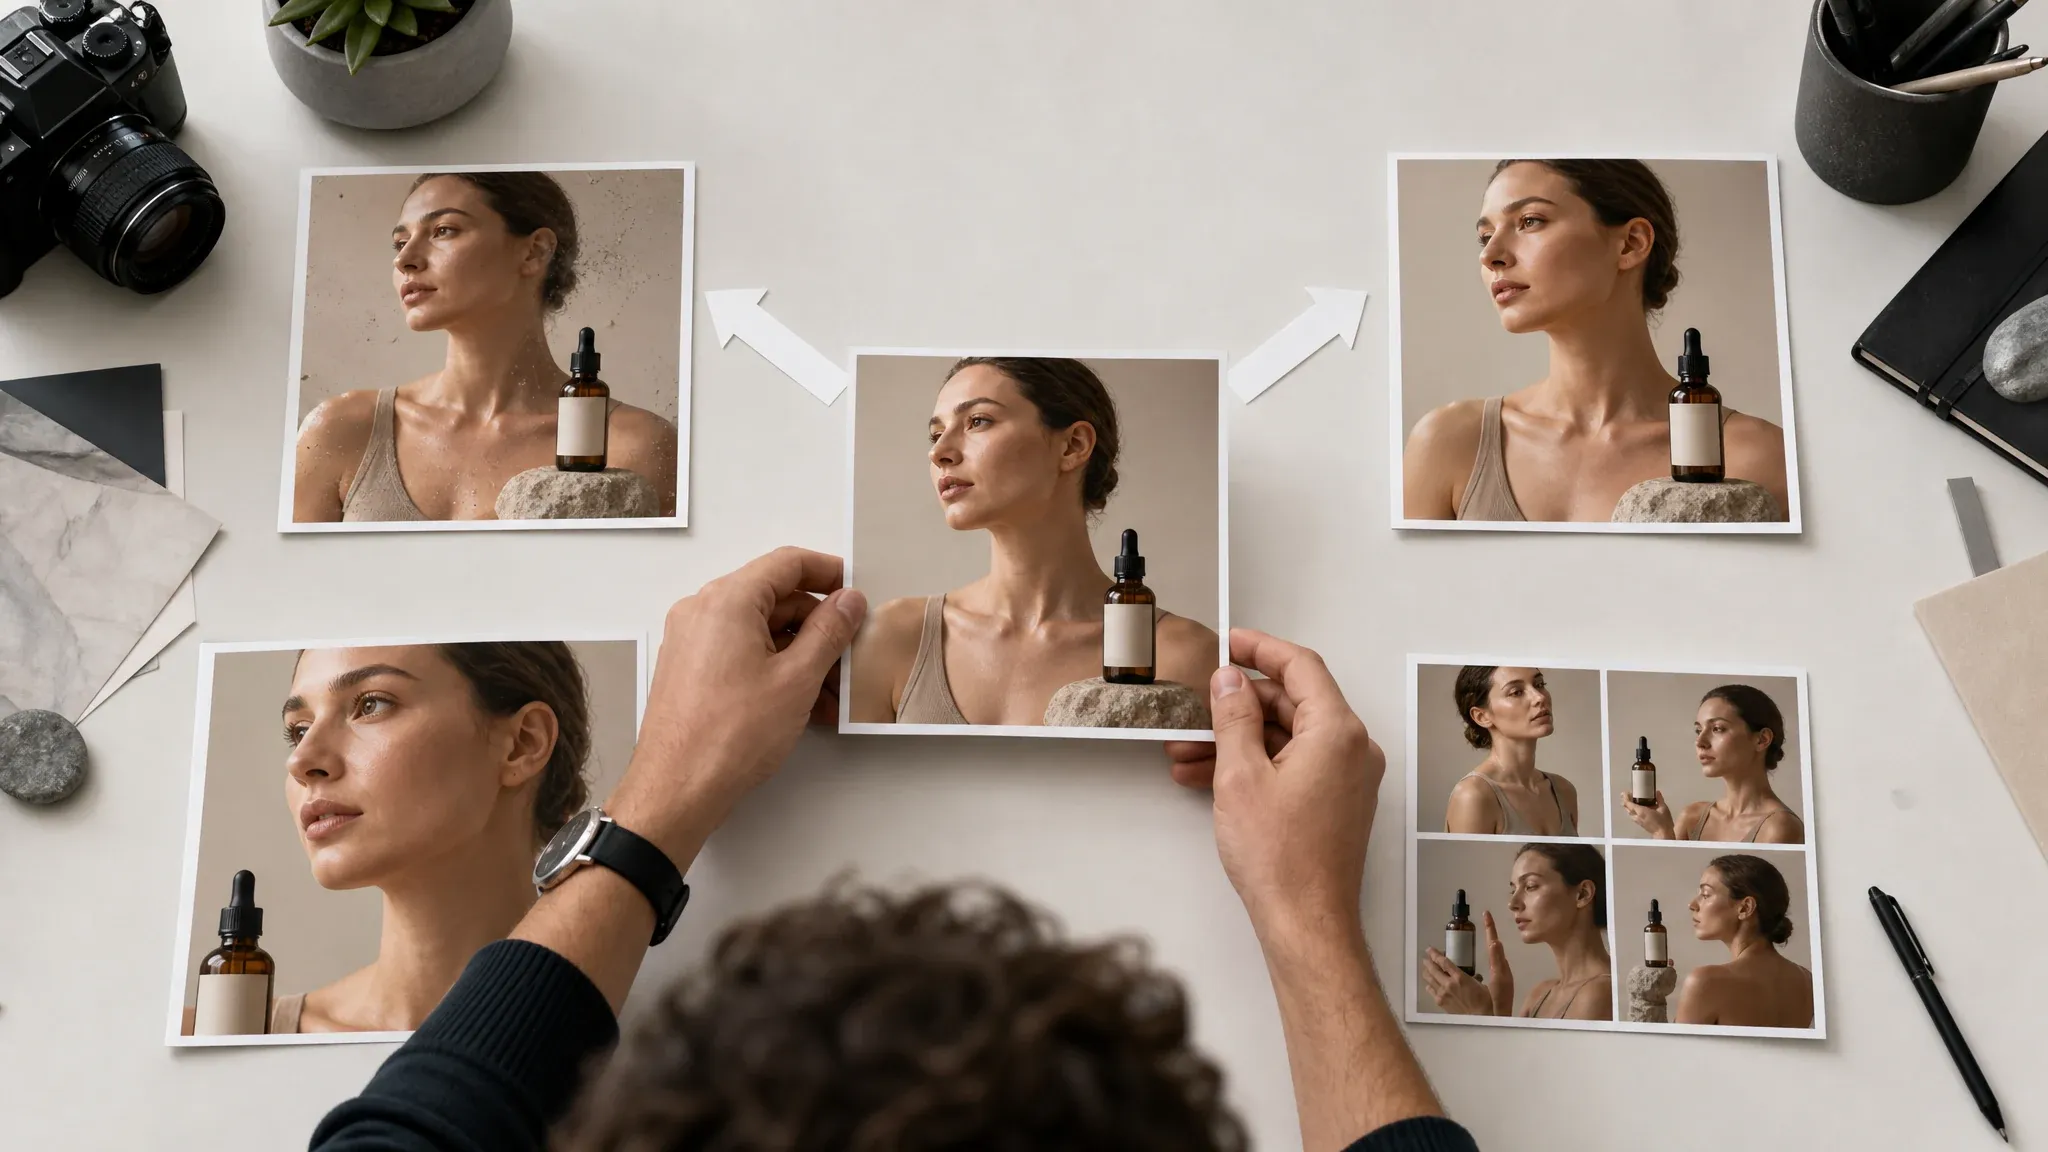
編集へ進む
1つの画像が目標に近づいたら再生成を停止。編集でクリーンアップ、image-to-imageで制御バリアント、アップスケーラーでシャープな出力、動画ツールでモーションテスト。
AI画像ジェネレーターとは?
AI画像ジェネレーターはテキストプロンプトから新しい画像を作成。被写体、シーン、スタイル、出力用途を説明すると、モデルが判断・調整可能なビジュアルドラフトを返します。
ソース画像なしで開始
シーンがまだ存在せず、ビジュアルの出発点が必要な場合にテキストのみを使用。
出力形状を選択
正方形、ポートレート、ストーリー、ワイド比率を選択し、テストするチャンネルに結果を適合。
適切な次のツールへ
最初の結果が明確な方向性を示したら、編集、リスタイル、アップスケール、アニメーション化。
プロンプト→画像ドラフトにFaceAIを使う理由
実際のワークベンチを最優先に構築し、いつ生成し、いつ調整し、いつプロンプト作成をやめるかをコンテンツで解説。
ツールが記事より先
ページ全体を読む前にプロンプトを記述可能。ユーザーはまず作成するためにAI画像ジェネレーターを開くので、ワークスペースが最優先。
プロンプトライブラリ+手動コントロール
ケース例から始め、例を固定テンプレートとして扱わず、被写体、背景、比率、スタイルを変更。
フォローアップ作業向けに設計
関連FaceAIツールがページパスの一部として組み込まれ、ほぼ完成した結果を編集、image-to-image、アップスケーリング、動画へ継続可能。
より良いAI画像ジェネレーター結果を得る方法
1つの被写体、1つのシーン、1つの照明方向、1つのスタイル。5つの競合するアイデアを含む長いプロンプトよりも効果的。
出力用途を指定
製品シーン、ブログカバー、サムネイル、ポートレートカバー、有料ソーシャルコンセプトなど。用途が構図を決定。
物理的詳細を使用
素材、表面、天候、レンズ距離、照明方向は、漠然としたムードワードよりも追従しやすい。
正確なテキスト要求を避ける
まず画像を生成。見出し、ロゴ、ブランドマークは後でデザインツールで追加。
一度に1つの変数だけ変更
結果が近い場合、背景、アングル、スタイルを個別に変更し、実際に何が改善されたかを確認。
AI画像ジェネレーター vs. ストック検索・手動デザイン・汎用ツール
適切なワークフローを選ぶための比較表。正直な答え:プロンプト→画像は迅速な方向性決定に最適であり、正確なブランドタイポグラフィや保証付き最終アートには不向き。
| 比較項目 | Face AIFaceAI 側 | 他のツール |
|---|---|---|
| 出発点 | FaceAIワークベンチ内のテキストプロンプトから新しいビジュアルドラフトへ | ストック検索は既存写真から、手動デザインは空白ファイルから開始 |
| 最適な用途 | 製品シーン、ソーシャルコンセプト、ブログカバー、サムネイル、初期アートディレクション | ストックは汎用シーンに、手動デザインはレイアウト確定時に最適 |
| スタイルコントロール | ツールエリア内でプロンプト、スタイル、比率、鮮明度、画像数を制御 | 一部のツールは設定をギャラリー背後に隠したり、1つのデフォルト出力形状に強制 |
| 次のステップ | ほぼ完成した結果をエディター、image-to-image、アップスケーラー、動画ツールへ | 多くのジェネレーターはダウンロードで終了、調整は別ワークフローに |
| 正確なロゴと読み取り可能なテキスト | 生成内では信頼できません。エクスポート後にタイポグラフィとブランドマークを追加 | ほとんどのAI画像ツールは同じ制限(ページに明記されていなくても) |
| 商用利用 | 出力を慎重に使用し、権利のない保護ブランド、公人、著作権キャラクターを避ける | 広範な権利主張はプロンプトと被写体に依存 |
| レビュー速度 | どのビジュアルルートにより多くのデザイン時間を割くべきかの判断に有用 | 従来のブリーフはデザイナーが最初のモックアップを作成するまで抽象的 |
出発点
FaceAIワークベンチ内のテキストプロンプトから新しいビジュアルドラフトへ
ストック検索は既存写真から、手動デザインは空白ファイルから開始
最適な用途
製品シーン、ソーシャルコンセプト、ブログカバー、サムネイル、初期アートディレクション
ストックは汎用シーンに、手動デザインはレイアウト確定時に最適
スタイルコントロール
ツールエリア内でプロンプト、スタイル、比率、鮮明度、画像数を制御
一部のツールは設定をギャラリー背後に隠したり、1つのデフォルト出力形状に強制
次のステップ
ほぼ完成した結果をエディター、image-to-image、アップスケーラー、動画ツールへ
多くのジェネレーターはダウンロードで終了、調整は別ワークフローに
正確なロゴと読み取り可能なテキスト
生成内では信頼できません。エクスポート後にタイポグラフィとブランドマークを追加
ほとんどのAI画像ツールは同じ制限(ページに明記されていなくても)
商用利用
出力を慎重に使用し、権利のない保護ブランド、公人、著作権キャラクターを避ける
広範な権利主張はプロンプトと被写体に依存
レビュー速度
どのビジュアルルートにより多くのデザイン時間を割くべきかの判断に有用
従来のブリーフはデザイナーが最初のモックアップを作成するまで抽象的
実際のワークフローでのAI画像ジェネレーター活用方法
プロセスに焦点:プロンプト、比較、方向性の選択、画像が十分に近づいた場合のみ調整。
"白紙のまま何も進まないときの、最初のひと押しに最適なツールです。"

Nina Volkov
Visual Design Director
"見出しは決まっているのに、ビジュアルの方向が固まらない記事カバーに使っています。プロンプトを1回回すだけで、チームが具体的に確認できる画像が手に入ります。"

Emma Johansson
Head of Content Strategy
"1発目をそのまま使おうとは考えません。キャンペーンの方向性を絞り込み、一番良い結果だけを編集に持ち込む使い方です。"

Mia Torres
Design Director
"ムードボード作りに便利。生成して、見て、すぐ捨てる。この速さが魅力です。"

Kai Nakamura
Global Creative Director
"レンズ、光、質感まで指定すると、プロンプトの効きがまったく違います。ブランドらしい大きな言葉だけでは届きません。"

Priya Chen
Creative Strategy Lead
"3つのビジュアル案を手で発注するより速い。チームが欲しいのは「反応できる方向性」だけですから。"

Astrid Nielsen
Head of Thought Leadership
"白紙のまま何も進まないときの、最初のひと押しに最適なツールです。"
Nina Volkov
Visual Design Director
"見出しは決まっているのに、ビジュアルの方向が固まらない記事カバーに使っています。プロンプトを1回回すだけで、チームが具体的に確認できる画像が手に入ります。"
Emma Johansson
Head of Content Strategy
"1発目をそのまま使おうとは考えません。キャンペーンの方向性を絞り込み、一番良い結果だけを編集に持ち込む使い方です。"
Mia Torres
Design Director
"ムードボード作りに便利。生成して、見て、すぐ捨てる。この速さが魅力です。"
Kai Nakamura
Global Creative Director
"レンズ、光、質感まで指定すると、プロンプトの効きがまったく違います。ブランドらしい大きな言葉だけでは届きません。"
Priya Chen
Creative Strategy Lead
"3つのビジュアル案を手で発注するより速い。チームが欲しいのは「反応できる方向性」だけですから。"
Astrid Nielsen
Head of Thought Leadership
"デザインの仕上げに入る前の段階で、ウェビナーのカバーや有料SNS広告の草稿に使っています。"

Haruka Kimura
Inbound Marketing Manager
"白紙のまま何も進まないときの、最初のひと押しに最適なツールです。"
Nina Volkov
Visual Design Director
"見出しは決まっているのに、ビジュアルの方向が固まらない記事カバーに使っています。プロンプトを1回回すだけで、チームが具体的に確認できる画像が手に入ります。"
Emma Johansson
Head of Content Strategy
"1発目をそのまま使おうとは考えません。キャンペーンの方向性を絞り込み、一番良い結果だけを編集に持ち込む使い方です。"
Mia Torres
Design Director
"ムードボード作りに便利。生成して、見て、すぐ捨てる。この速さが魅力です。"
Kai Nakamura
Global Creative Director
"レンズ、光、質感まで指定すると、プロンプトの効きがまったく違います。ブランドらしい大きな言葉だけでは届きません。"
Priya Chen
Creative Strategy Lead
"3つのビジュアル案を手で発注するより速い。チームが欲しいのは「反応できる方向性」だけですから。"
Astrid Nielsen
Head of Thought Leadership
"デザインの仕上げに入る前の段階で、ウェビナーのカバーや有料SNS広告の草稿に使っています。"
Haruka Kimura
Inbound Marketing Manager
"まだ世の中にないシーンを作るときが一番強いです。近い結果が出たら、プロンプトを10回書き直すより、画像から画像へ渡すほうが早い。"

Ananya Iyer
Content Marketing Lead
"多くのジェネレーターの1発目はストック写真っぽくなります。これも明確なプロンプトは必須ですが、広告に使えるコンセプトまで操縦しやすい。"

Aaliyah Williams
Digital Marketing Director
"普段は緩いムード参考画像から始めるキャンペーン企画で試しました。価値は1発目の完成度ではなく、どのビジュアルルートに本気のデザイン時間をかけるか、素早く決められることです。"

Rafael Santos
VP of Creative
"SEOチームの議論が抽象論で止まらず、実際の画像に反応できるようになりました。"

Charlotte Beaumont
Director of Content Operations
"LP制作では、コピーが固まる前にビジュアル案が必要です。スプリントを止めずに、そこまで持っていけます。"

Jordan Kim
Growth Lead
"画像のトーンを文章で説明しづらい、ストーリー主導の企画に一番合います。2〜3バージョン生成して見比べ、1つだけ残して磨く。何の支えもないデザインファイルから始めるより、ずっと速いです。"

Marie Laurent
Storytelling & Brand Lead
"広告の初稿としては十分な力です。特に、商品・シチュエーション・カメラ距離まで書いたときに強い。"

Yifan Zheng
Demand Generation Lead
"まだ世の中にないシーンを作るときが一番強いです。近い結果が出たら、プロンプトを10回書き直すより、画像から画像へ渡すほうが早い。"
Ananya Iyer
Content Marketing Lead
"多くのジェネレーターの1発目はストック写真っぽくなります。これも明確なプロンプトは必須ですが、広告に使えるコンセプトまで操縦しやすい。"
Aaliyah Williams
Digital Marketing Director
"普段は緩いムード参考画像から始めるキャンペーン企画で試しました。価値は1発目の完成度ではなく、どのビジュアルルートに本気のデザイン時間をかけるか、素早く決められることです。"
Rafael Santos
VP of Creative
"SEOチームの議論が抽象論で止まらず、実際の画像に反応できるようになりました。"
Charlotte Beaumont
Director of Content Operations
"LP制作では、コピーが固まる前にビジュアル案が必要です。スプリントを止めずに、そこまで持っていけます。"
Jordan Kim
Growth Lead
"画像のトーンを文章で説明しづらい、ストーリー主導の企画に一番合います。2〜3バージョン生成して見比べ、1つだけ残して磨く。何の支えもないデザインファイルから始めるより、ずっと速いです。"
Marie Laurent
Storytelling & Brand Lead
"広告の初稿としては十分な力です。特に、商品・シチュエーション・カメラ距離まで書いたときに強い。"
Yifan Zheng
Demand Generation Lead
AI画像生成後に試すべきこと
最適な次のツールは最初の結果の問題に依存:小さな欠陥、スタイル変更、ソフトな出力、または動きの必要性。
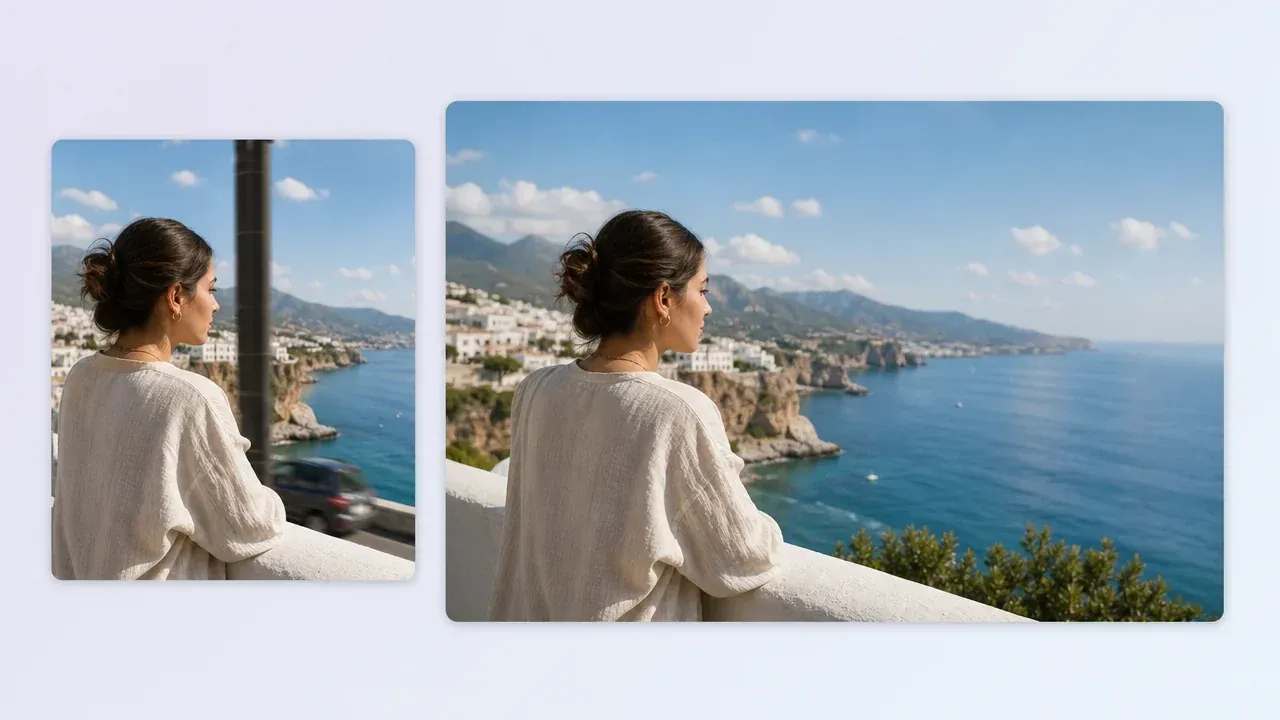
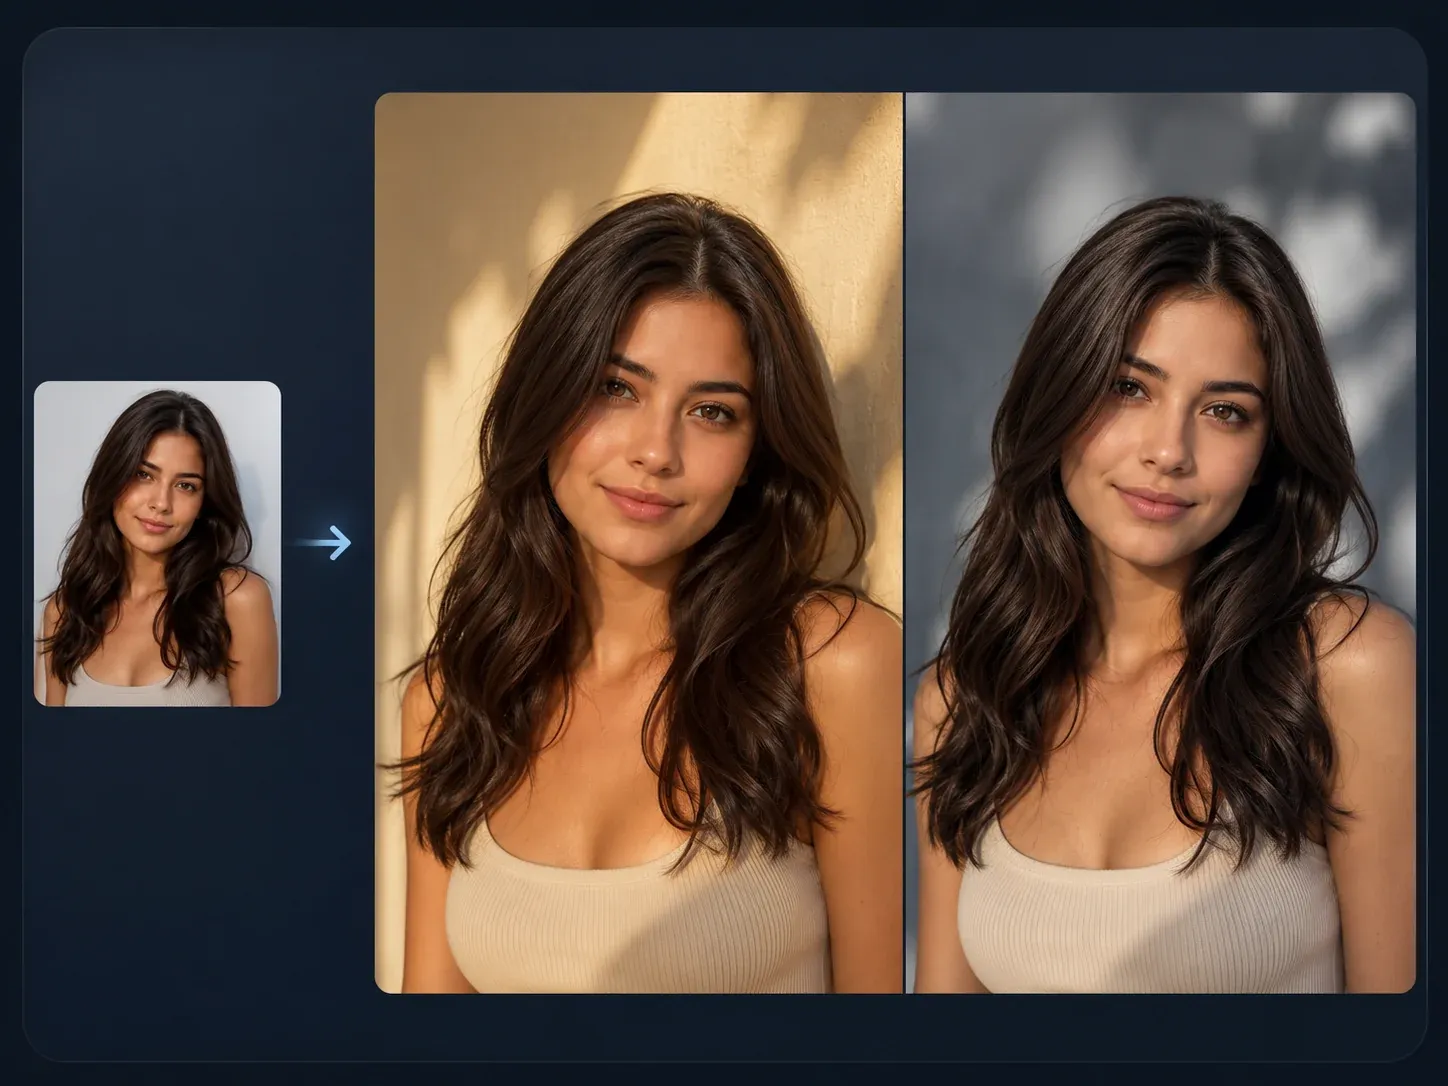
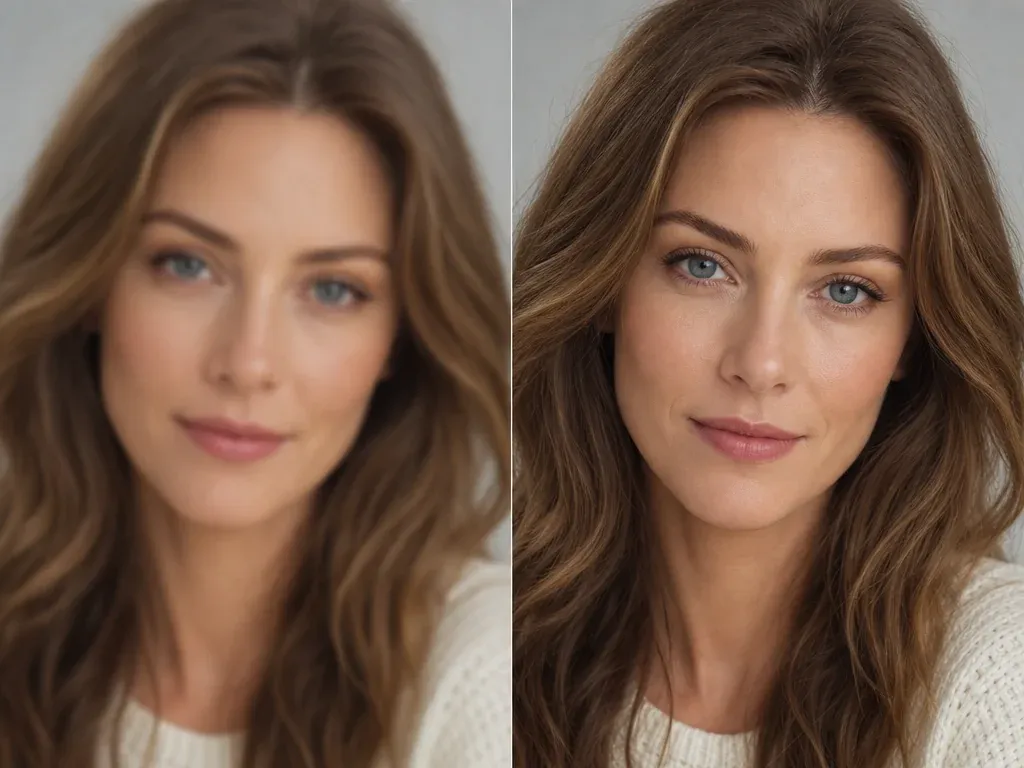
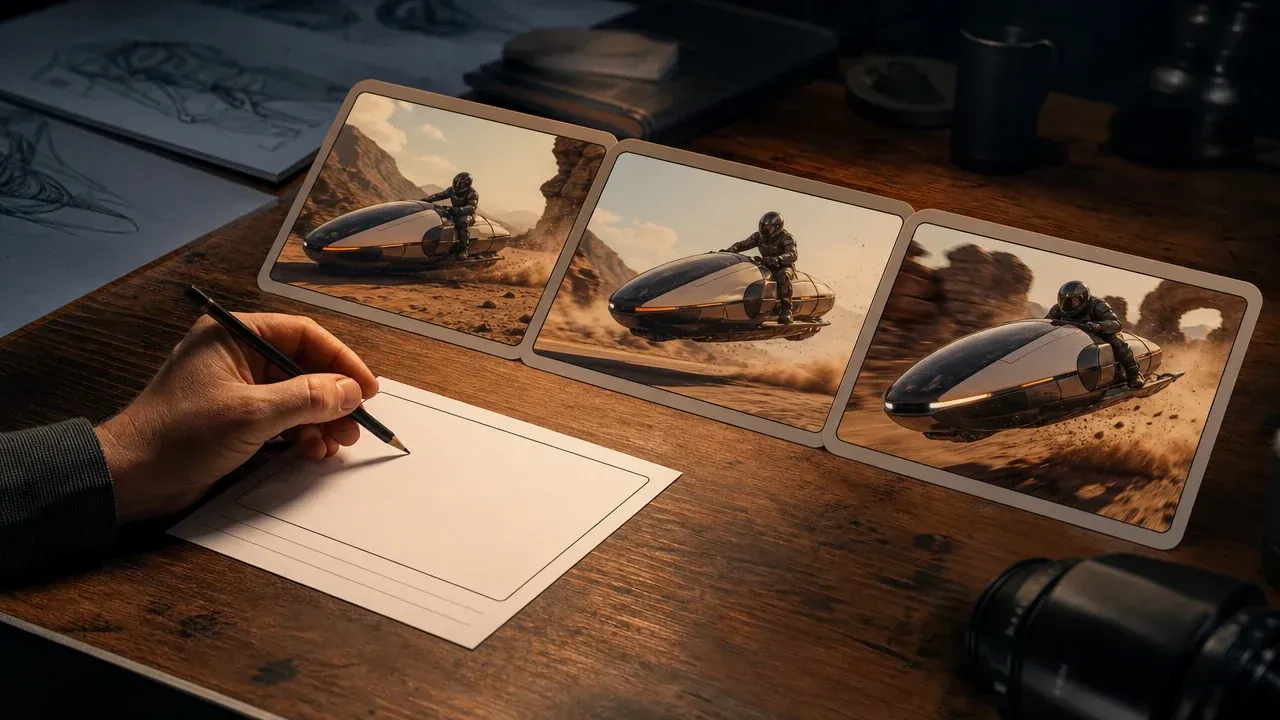
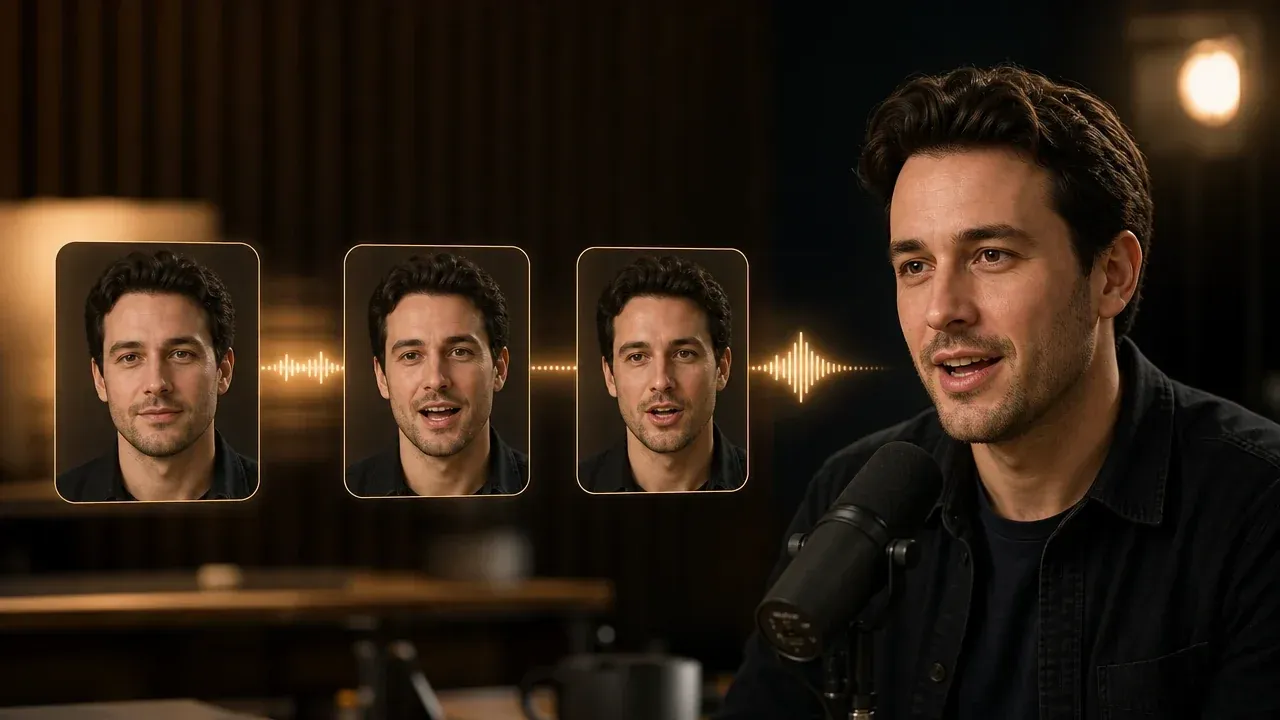
AI画像ジェネレーターの質問と回答
プロンプト作成、ソース画像、出力品質、ダウンロード方法、権利、ツール切替時期についての簡潔な回答。
AI画像ジェネレーターはテキストプロンプトから新しい画像を作成。被写体、背景、スタイル、出力用途を説明し、生成されたビジュアルドラフトを確認。
被写体から始め、背景、カメラ距離、照明、スタイル、最終用途を追加。最初のプロンプトは具体的に、詰め込みすぎない。
いいえ。このページはプロンプト→画像です。既にソース画像がありレイアウトを維持したい場合は、AI画像変換を使用。
正方形投稿には1:1、ストーリーには9:16、カバー風ポートレートには3:4、ワイドヒーロー画像やサムネイルには16:9。
凡庸なプロンプトは物理的詳細が不足。素材、場所、カメラ距離、照明、対象チャンネルを追加し、モデルに明確な目標を与える。
信頼性は低い。まずビジュアルを生成し、その後でデザインツールで正確なタイポグラフィ、ラベル、ブランドマークを追加。
画像の方向性は近いが一部に制御が必要な場合に切替。エディターでクリーンアップ、image-to-imageでバリアント、アップスケーラーでシャープな出力。
はい。ワークベンチに結果が表示されたら、画像近くのダウンロードコントロールを使用。最終プレビューが表示されるまでページを開いたままに。
はい。プロンプトフィールド、スタイル選択、比率コントロール、結果プレビュー、履歴、ダウンロード、共有アクションはすべてタッチスクリーン対応。
自己プロジェクトで出力を使用可能ですが、権利クリアランスはプロンプトと被写体に依存。権利のない商標ロゴ、著作権キャラクター、公人、ブランドアセットを避ける。
AI画像ジェネレーターを始める
1つの明確なプロンプトを書き、最初のビジュアルドラフトを生成し、どの方向性を維持する価値があるかを確認した後にのみ結果を調整。